GFXBench 图形测试的鸿蒙移植
我们把 GFXBench 的 Aztec Ruins 图形负载接入鸿蒙应用时,将工作分成了两个部分:ArkTS 负责测试选择、资源准备、运行页面和结果保存,原生层负责图形上下文、场景初始化、渲染循环及计分。两部分通过 NAPI 交换测试描述和结果,通过 XComponent 提供的 NativeWindow 连接系统显示链路。
目录
我们把 GFXBench 的 Aztec Ruins 图形负载接入鸿蒙应用时,将工作分成了两个部分:ArkTS 负责测试选择、资源准备、运行页面和结果保存,原生层负责图形上下文、场景初始化、渲染循环及计分。两部分通过 NAPI 交换测试描述和结果,通过 XComponent 提供的 NativeWindow 连接系统显示链路。
这套实现使用 GFXBench 5.1.5 源码中的 scene5 模块,提供 OpenGL ES 与 Vulkan 两条图形后端。菜单覆盖 Aztec Ruins 5.0、5.1 的 Normal Tier、High Tier,以及 1080p、1440p、4K 离屏组合,共 20 个配置入口。5.0、5.1 是测试配置系列,与图形 API 版本无关:OpenGL ES 配置使用 ES 3.1,Vulkan 配置使用 Vulkan 1.0。
本文围绕现行执行链路解释每个接口的用途,给出资源布局、窗口条件、计时口径和结果结构。文中的分辨率与工作量图来自实际配置,用来说明测试条件。
一次测试经过哪些层
GFXBench 鸿蒙执行链路
UI 轮询不驱动渲染,GLES 与 Vulkan 在原生后端分流
图形上下文与渲染循环由工作线程管理;原始结果 JSON 返回 ArkTS 保存。
文字版
| 步骤 | 说明 | 去向 |
|---|---|---|
| ArkTS 测试流程 | 选择配置、准备资源;等待横屏 Surface 稳定 | Native runner、XComponent |
| Native runner | 解析 Descriptor、创建 worker;init → run → result → terminate | scene5 / TestBaseGFX |
| scene5 / TestBaseGFX | 预热、动画更新、渲染、命令提交;TimeComponent 计时与结果生成 | OpenGL ES 3.1、Vulkan 1.0 |
| XComponent | NativeWindow + 实际尺寸;创建 / 尺寸变化 / 销毁回调 | OpenGL ES 3.1 |
| OpenGL ES 3.1 | EGL window surface + context;eglMakeCurrent / eglSwapBuffers | |
| Vulkan 1.0 | VK_OHOS_surface;NativeWindow → VkSurface |
首页先确定测试集合,将对应配置文件读成 JSON。运行页取得准备好的资源根目录和描述文件,等待横屏 Surface 稳定,再调用原生 start()。原生 runner 创建工作线程,解析 tfw::Descriptor,选择图形后端,创建 tfw::TestBase,依次调用 init()、run()、result() 与 terminate()。结果以 JSON 回到 ArkTS,并保留原始文本。
这里保留原测试框架对场景与计分的控制。ArkTS 的 250 ms 状态轮询只用于页面更新,不驱动渲染,不决定单帧时间,也不参与 FPS 分母计算。界面刷新频率可以独立调整,基准循环不受影响。
运行器只接受 factory_method = gl_5,通过静态链接的工厂创建 scene5 测试。这个工厂名字来自框架接口,Vulkan 配置同样使用它;图形 API 由描述文件和后端选择逻辑决定,GLES 与 Vulkan 共用同一个运行页。
先让原生引擎找到资源
场景运行需要模型、纹理、配置与着色器。应用打包时使用 rawfile 保存这些文件,首次使用时将它们复制到应用私有目录,保留引擎需要的相对路径:
| 打包资源 | 安装后的相对目录 | 用途 |
|---|---|---|
| 场景数据 | data/ | 模型、纹理、场景描述 |
| 测试配置与界面资源 | resources/ | 各 API、版本和档位的描述文件 |
| 着色器 | data/gfx/shaders/ | 场景加载与渲染程序 |
这种布局让原生引擎继续通过文件接口读取资源。runner 根据 data_prefix 建立读写根目录;Aztec Ruins 使用 gfx,因此传入引擎的是安装目录下的 data/gfx/。应用自己的绝对沙箱路径留在运行时,不写进测试配置。
复制 rawfile 时,要同时使用资源描述符的 fd、offset 与 length:rawfile 位于打包文件中的一个区间,不是从零偏移开始的独立文件。安装器使用 1 MiB 缓冲分段复制,每处理八个文件向事件循环让出一次执行机会,并在完成后写入布局版本、文件数和总字节数标记。
安装器用这个标记判断资源是否需要重新安装:布局版本或文件集合变化时,重新复制整套资源。标记记录的是集合信息,不做逐文件哈希。
等待横屏 Surface 稳定后再开始
运行页使用 XComponentType.SURFACE,由原生回调取得 NativeWindow 及其尺寸。Surface 创建或尺寸变化时,回调更新共享状态;Surface 销毁时,回调清除共享窗口信息。下面是这一接入关系的精简示意,省略页面状态字段和错误展示:
import { start, cancel } from 'libentry.so';

// 放在运行页 build() 内。
XComponent({
  id: 'gfxbench_surface',
  type: XComponentType.SURFACE,
  libraryname: 'entry'
})
  .width('100%')
  .height('100%')
  .onLoad(() => this.startWhenSurfaceReady())
  .onDestroy(() => cancel());

// startWhenSurfaceReady() 完成横屏、尺寸和稳定性检查后调用:
// start(descriptorJson, installRoot);
onLoad 触发时,窗口往往还没有完成转为横屏,尺寸还会变化。运行页因此每隔 150 ms 重试,要求宽度大于高度,并连续四次观察到相同尺寸后才提交启动,最多重试 200 次;没有可用 Surface 时,原生入口也会拒绝启动。
进入运行页时,应用请求横屏、全屏、隐藏系统栏、屏幕常亮,并把窗口亮度设为 1.0。离开时恢复此前的方向、亮度和常亮状态。这些设置属于测试环境的一部分:做功耗或温度比较时,亮度条件随结果一起记录。
XComponent 还向系统提交 60–120 Hz、期望 120 Hz 的帧率范围请求;实际刷新节奏由显示链路决定,结果里记录的是引擎实测的帧数和时间。
同一个 NativeWindow 怎样接到两条后端
原生 runner 将配置中的图形 API 与颜色、深度、模板、多重采样需求交给图形上下文。OpenGL ES 路径创建 EGL window surface 和 context;Vulkan 路径先保存 NativeWindow,随后由 NGL 后端创建鸿蒙 Vulkan surface。
下面是后端分流的结构摘录,省略了失败状态写回与清理:
const tfw::ApiDefinition api = PreferredGraphicsVersion(descriptor);
auto context = std::make_unique<EGLGraphicsContext>();

if (api.type() == tfw::ApiDefinition::VULKAN) {
    // 此函数保存 NativeWindow 并标记 Vulkan 路径。
    // 真正的 VkSurface 随后由 NGL 的 OHOS 分支创建。
    if (!context->initVulkanWindowSurface(nativeWindow)) {
        return;
    }
} else {
    context->setFormat(FormatFromDescriptor(descriptor));
    const auto es = PreferredESVersion(descriptor);
    context->setContextVersion(es.major(), es.minor());
    if (!context->initWindowSurface(nativeWindow)) {
        return;
    }
}
EGLGraphicsContext 这个类名沿用自上游框架,Vulkan 路径并不经过 EGL:这个上下文对象在 Vulkan 路径上只负责保存 NativeWindow,实际的 Vulkan surface 由后端通过 VkSurfaceCreateInfoOHOS 和 vkCreateSurfaceOHOS 建立,实例扩展中加入 VK_OHOS_surface。GLES 路径则由 eglCreateWindowSurface、eglCreateContext 和 eglMakeCurrent 建立执行环境。
这种适配把平台差异限制在窗口与上下文交接处,后续场景仍经 NGL 组织命令。两个后端共享测试框架和场景,各自走自己的驱动、着色器编译和提交路径,结果按 API 分开保存。
离屏分辨率决定了什么
屏幕测试使用实际窗口条件,离屏测试使用描述文件指定的渲染目标尺寸。当前 Normal Tier 离屏为 1920×1080,High Tier 离屏分别为 2560×1440 和 3840×2160。每个组合都分别提供 5.0、5.1 及 GLES、Vulkan 入口。
| 测试条件 | 指定渲染尺寸 | 每帧像素数 | 相对 1080p 像素数 |
|---|---|---|---|
| Normal Tier 1080p Offscreen | 1920×1080 | 2,073,600 | 1.000 |
| High Tier 1440p Offscreen | 2560×1440 | 3,686,400 | 1.778 |
| High Tier 4K Offscreen | 3840×2160 | 8,294,400 | 4.000 |
离屏目标的像素规模
配置数据 · 各档位渲染目标的像素数
Normal 与 High 是不同的场景档位;像素数描述渲染目标的规模。
数据表
| 类别 | 离屏像素数 / 像素 |
|---|---|
| Normal Tier 1080p(1920 × 1080) | 2,073,600 px · 1.000 × 1080p |
| High Tier 1440p(2560 × 1440) | 3,686,400 px · 1.778 × 1080p |
| High Tier 4K(3840 × 2160) | 8,294,400 px · 4.000 × 1080p |
这张图表达的是各档位渲染目标的像素规模。Normal 与 High 使用不同的场景档位,所以从 1080p Normal 到 1440p High,变化的不只是像素数;同为 High 的 1440p 与 4K,像素数相差 2.25 倍,帧率差异由带宽、缓存与执行单元共同决定。结果按档位和分辨率分别保存。
离屏测试同样需要横屏 NativeWindow:引擎的屏幕管理组件把场景渲染到指定尺寸的离屏目标,再安排显示提交。运行页对两类测试使用同一套 Surface 等待逻辑。
20 个菜单入口的 play_time 都为 64,300 ms,start_animation_time 为零。这是场景的正式计时时长;一次运行的总时长还包括资源安装、场景初始化、预热、最后一帧与收尾同步。结果按菜单项保存,键是 API、配置系列和档位的组合,因为 5.0 与 5.1 复用同一个引擎 test_id。
帧率的分母从哪里来
引擎先完成场景初始化与预热,再进入正式循环。初始化阶段会加载场景、创建屏幕管理组件、预热场景、等待提交完成,并进行初始交换。TimeComponent::BeginTest() 在正式执行阶段启动计时器。
循环按组件组织:开始一帧、选择命令缓冲、更新动画、渲染、结束与提交命令缓冲、执行提交后处理,随后根据屏幕管理组件的要求交换缓冲。完成后增加帧数,并更新用于页面观察的累计 FPS。这个累计值使用从正式开始到当前时刻的时间,不是滑动窗口瞬时 FPS。
结束时,屏幕管理组件完成最后的提交与等待,再停止计时器并生成结果。因此这里的帧率是应用与图形后端共同完成整帧(含提交和交换)的速率。
加载、预热与正式测量的边界
各段只表示先后顺序,宽度不按时间
页面整轮 durationMs 覆盖准备、测试与切换,与引擎计时分开保存。
文字版
| 阶段 | 说明 | 所属区间 |
|---|---|---|
| 资源准备 | 安装场景和配置 | |
| init / 加载 | 记录 load_time | load_time |
| 预热与同步 | Warmup / 初始交换 | |
| 正式渲染 | BeginTest 启动计时 | elapsed_time / measured_time |
| 收尾与等待 | WaitFinish,随后 StopTimer | elapsed_time / measured_time |
| 解析与保存 | 原始 JSON / 历史 |
三个时间需要分开理解:load_time 记录场景加载阶段,在预热前取得;elapsed_time 与 measured_time 记录测试计时器的时间;应用历史中的 durationMs 则覆盖整轮页面执行,包括准备与项目间切换。结果页使用引擎产生的计时值。
最终 FPS 与归一化帧数的关系可用下面的独立 C++ 示例表达。它只演示计算口径,不包含场景渲染代码:
#include <cmath>
#include <cstdint>
#include <optional>

struct Rates { double fps; double normalizedFrames; };

std::optional<Rates> MakeRates(std::uint64_t frames,
                               double elapsedMs,
                               double nominalMs) {
    if (!std::isfinite(elapsedMs) || elapsedMs <= 0 ||
        !std::isfinite(nominalMs) || nominalMs <= 0) {
        return std::nullopt;
    }
    const double fps = static_cast<double>(frames) * 1000.0 / elapsedMs;
    const double score = static_cast<double>(frames) * nominalMs / elapsedMs;
    return Rates{fps, score};
}现行引擎默认开启归一化计分:score = 实际帧数 × 名义测试时长 / 实际测量时长。frame_count 保存实际完成帧数,所以单位写成 frames 的 score 与 frame_count 并不相等。两个字段分别保留,收尾时间或最后一帧造成的差异由此可以看出来。
工作线程、取消与结果状态
渲染在独立的 std::thread 中执行。启动前 join 上一轮已进入终态的线程,等待其收尾完成;运行期间拒绝再次启动,避免同一个窗口被两轮测试同时使用。状态以 idle、running、finished、failed、cancelled 表达,结果文本与实时累计 FPS 通过互斥保护共享。
取消是协作式的:cancel() 设置原子标记并通知当前测试对象,初始化后以及 run() 返回后各检查一次,工作线程在检查点退出并释放上下文。运行页销毁时先调用 cancel(),Surface 销毁回调随后清除共享窗口状态。
正常执行路径调用 terminate(),随后解除线程绑定并销毁上下文;异常分支写入失败状态并销毁上下文。
结果解析遍历引擎 results 数组,为每项保存状态、score、FPS、实际帧数、渲染尺寸、加载时间和原始 JSON。批量执行时,一个项目失败后继续下一个项目;取消会停止后续项目,已完成项目的结果留在运行页,不写入历史。
历史中的 totalScore 是通过项分数之和,averageFps 是各项 FPS 的算术平均,用于应用内浏览一轮批量运行。对外比较使用单项结果,并标明 API、配置系列、档位、屏幕/离屏和实际尺寸。
运行画面与结果解读
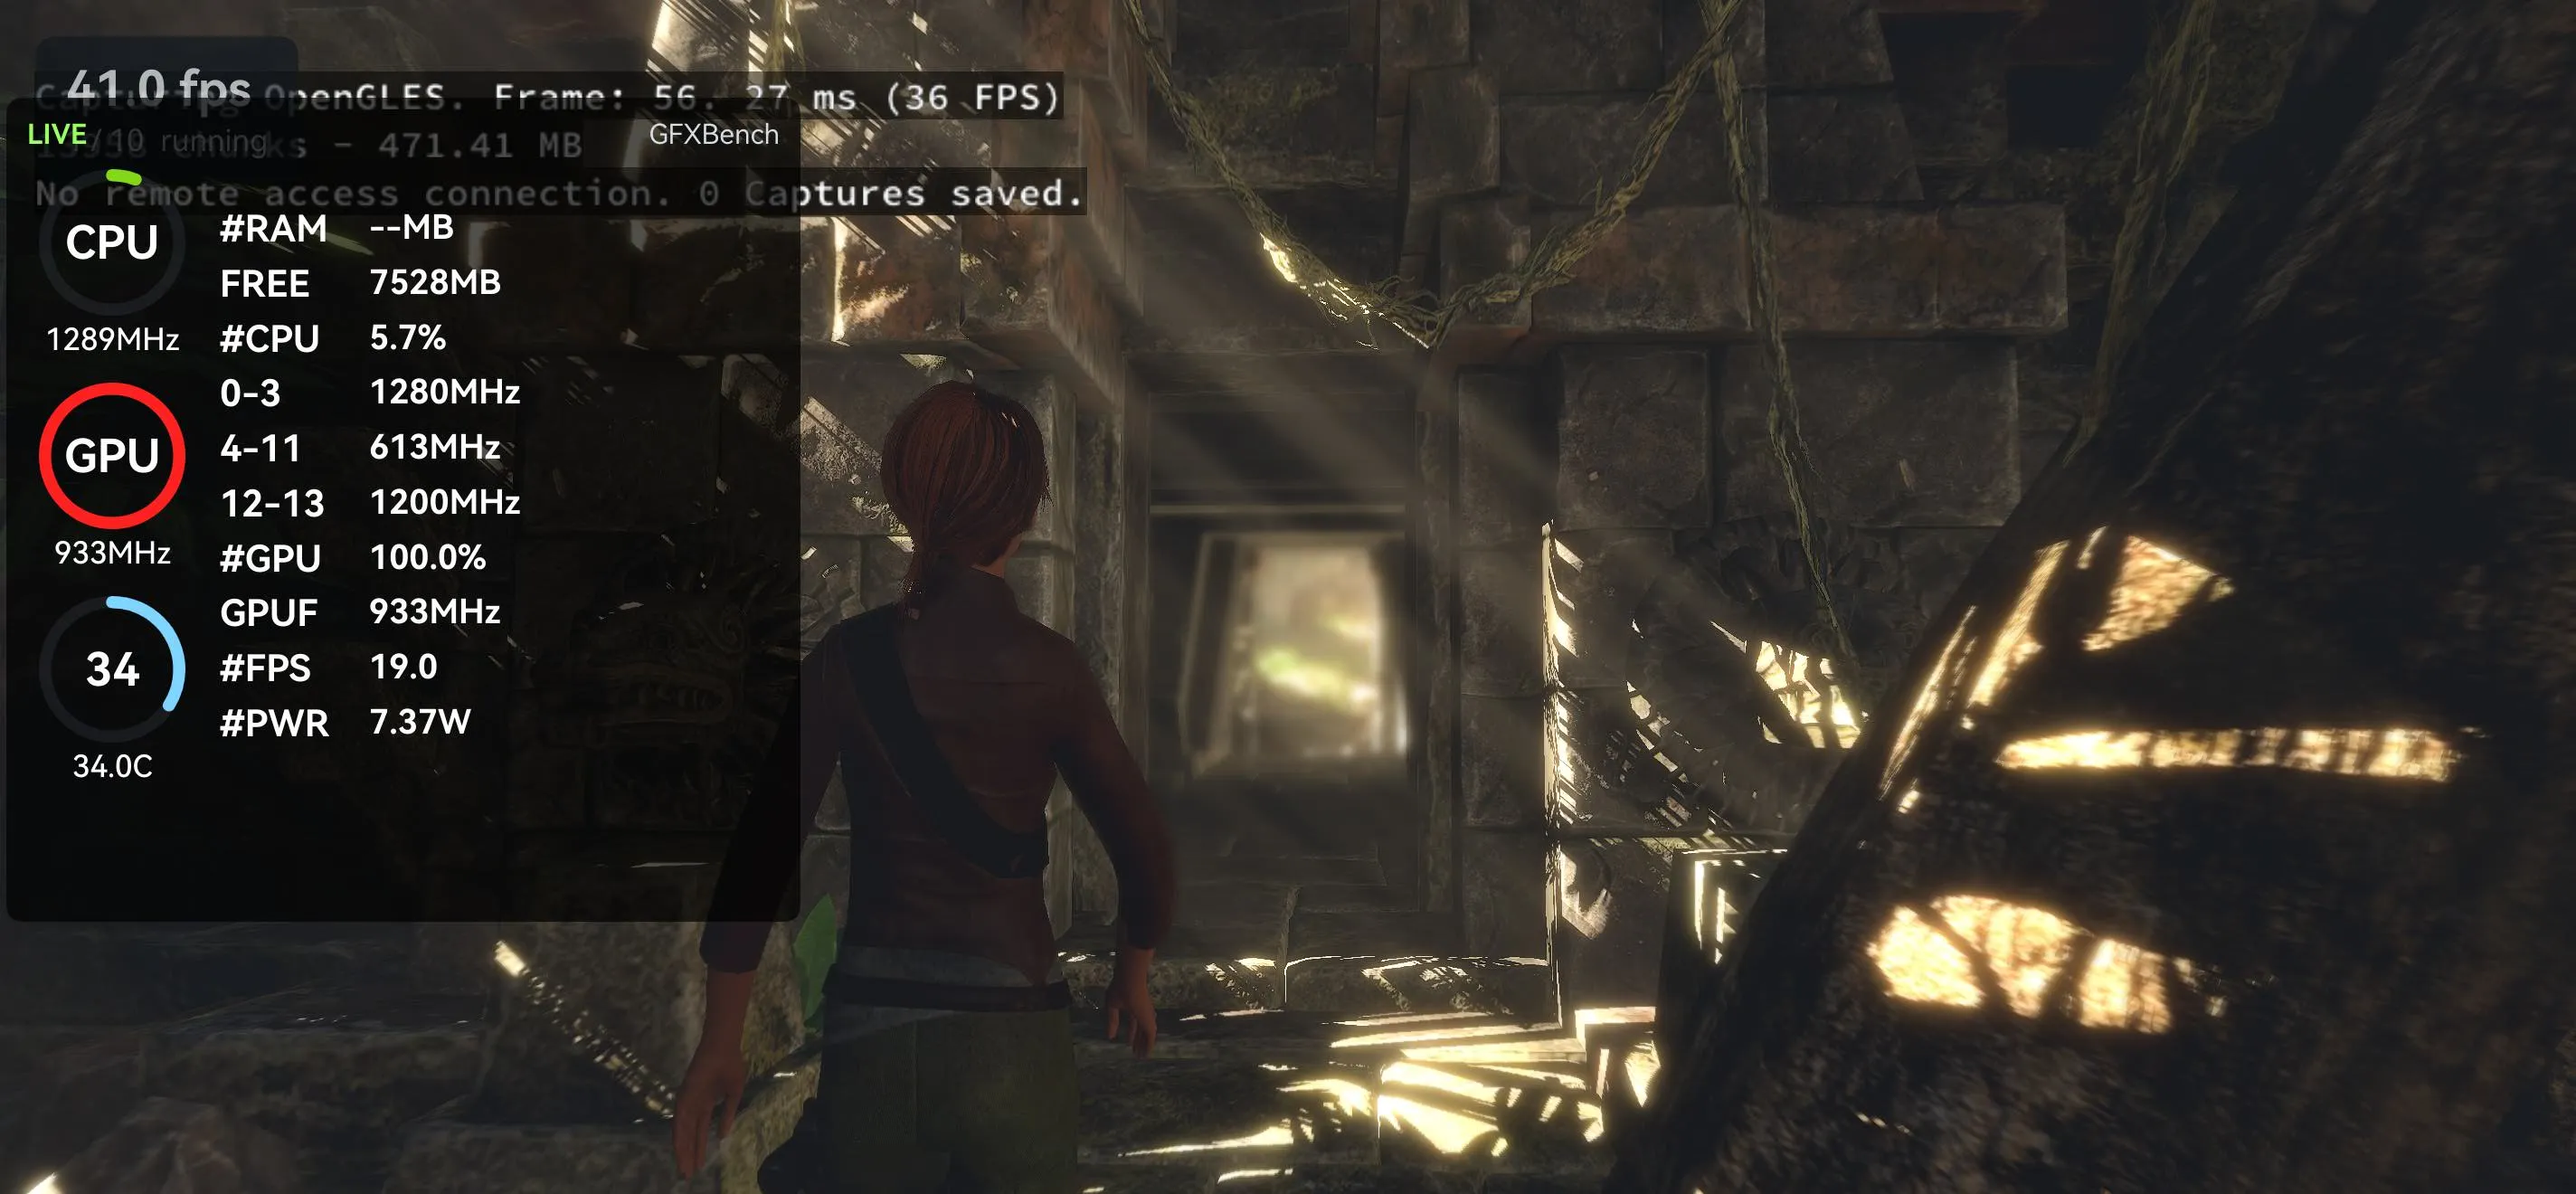
这张运行截图展示了图形场景与 MonitorHarmony 悬浮窗同时显示的状态:画面呈现图形场景,监控浮窗在其上方显示 CPU、GPU、内存、温度和功耗等读数。它说明了图形测试和手机端监控在同一屏幕上的使用方式。
画面里的几处 FPS 分别来自引擎的调试文字和监控浮窗,统计窗口不同,数值也不同。正式成绩以引擎结果中的 FPS、帧数与计时为准,并附带这一轮的测试配置。
构建与使用条件
现行应用配置以 HarmonyOS API 23 为目标与兼容版本。原生部分使用 C++17,构建 scene5、测试框架、KCL 和 NGL,链接 NAPI、XComponent、NativeWindow、EGL、GLES 与 Vulkan 库。CMake 对基准代码启用 -O3、NDEBUG,并强制 Release 构建。
使用时先完成资源准备,再选择图形 API 和具体测试条件,保持横屏,等待原生 Surface 稳定后执行。结果比较使用同一配置组合,并记录实际尺寸与运行环境。
这套移植把场景执行、图形 API、窗口生命周期和结果口径分别安放在清楚的位置:原测试框架管理负载和计时,原生平台层连接鸿蒙窗口与驱动,ArkTS 管理操作流程与记录。用户看到的每个 FPS 数字都能回到这一轮实际使用的描述文件、渲染尺寸和引擎结果。
评论
欢迎讨论,不用登录。评论会直接显示;骂人和广告会被删掉。
管理
评论
加载中……